Snowflake ya no obliga a elegir entre data lake y data warehouse.
Con las Iceberg Tables puedes consultar y escribir datos en formato abierto, sobre almacenamiento que tú controlas, usando el motor de consulta de Snowflake.
En este artículo repasamos qué son las Iceberg Tables en Snowflake, cómo funcionan, de qué depende su rendimiento y cuándo conviene usarlas, basándonos en la documentación oficial de Snowflake y en buenas prácticas de proyectos de datos.
El problema: datos duplicados entre el data lake y el data warehouse
El patrón clásico genera fricción:
- los datos viven en un data lake (Parquet en S3, ADLS o GCS)
- para analizarlos con rendimiento, se copian dentro del data warehouse
- aparecen copias duplicadas, pipelines de carga y costes de almacenamiento repetidos
Resultado: el mismo dato en dos sitios, con sincronización frágil y gobierno difícil.
La propuesta de las Iceberg Tables: trabajar sobre un único dataset en formato abierto, consultable por Snowflake y por otros motores, sin mantener una segunda copia analítica completa dentro de Snowflake.
¿Qué son las Iceberg Tables?
Las Iceberg Tables combinan el motor de consulta y las capacidades de Snowflake con el formato abierto Apache Iceberg. Sus datos y metadatos pueden residir en almacenamiento proporcionado por Snowflake o en tu propia nube mediante un external volume. Son especialmente útiles para arquitecturas lakehouse, interoperabilidad entre motores y data lakes existentes.
Usan la especificación de formato de tabla abierto Apache Iceberg, que aporta:
- Transacciones ACID: lecturas consistentes y escrituras atómicas
- Evolución de esquema: añadir, eliminar, renombrar o reordenar columnas y ciertos cambios de tipo compatibles, sin reescribir todos los ficheros existentes
- Particionado oculto: las consultas filtran por columnas de negocio sin depender de las rutas físicas de los ficheros
- Snapshots: versiones consistentes de la tabla para consultas históricas, rollback y auditoría, sujetas a la política de retención y al modelo de catálogo
En Snowflake, las Iceberg Tables se apoyan en el formato de fichero Apache Parquet.
Cómo encajan en Snowflake: catálogo + ubicación de almacenamiento
Una Iceberg Table se sustenta en dos piezas:
- El catálogo: qué sistema gestiona los metadatos de la tabla (Snowflake o un catálogo externo)
- La ubicación de almacenamiento: dónde viven datos y metadatos
Para la ubicación hay dos modelos:
- Almacenamiento de Snowflake: Snowflake proporciona y administra el almacenamiento. Se indica con EXTERNAL_VOLUME = ‘SNOWFLAKE_MANAGED’ (o por defecto cuando el catálogo es Snowflake); no necesitas crear ningún objeto external volume.
- Almacenamiento gestionado por ti: tu bucket en S3, ADLS o GCS, al que Snowflake accede mediante un external volume.
Esa separación entre catálogo y almacenamiento es la base del formato abierto: cuando usas tu propio almacenamiento, los datos no quedan encerrados en Snowflake.
De qué depende el rendimiento de una Iceberg Table
El rendimiento no es automático: depende de cómo estén organizados los ficheros y los metadatos. Las palancas principales son:
- Metadatos y estadísticas: Snowflake usa los metadatos Iceberg y las estadísticas de los ficheros para saltarse datos irrelevantes (pruning) y leer menos.
- Tamaño de los ficheros Parquet: ficheros demasiado pequeños penalizan; Snowflake permite ajustar el tamaño objetivo de los ficheros que escribe.
- Mantenimiento: compactación de datos y de manifests, y expiración de snapshots, evitan la degradación con el tiempo.
- Clustering: en tablas gestionadas por Snowflake puede aplicarse Automatic Clustering sobre columnas de filtrado frecuentes.
- Localidad: si el almacenamiento y la cuenta de Snowflake están en regiones distintas, aparece latencia y coste de egress.
En las tablas gestionadas por un catálogo externo, Snowflake no realiza estas operaciones de mantenimiento: deben ejecutarse con el catálogo o motor Iceberg externo (expiración de snapshots, limpieza de metadatos antiguos, compactación), alineando el refresco de Snowflake con cada operación.
Dos modelos de catálogo (la decisión clave)
Snowflake admite dos opciones de catálogo para Iceberg, y elegir bien es lo más importante:
- Snowflake como catálogo (tabla gestionada por Snowflake)
- soporte completo de la plataforma, con acceso de lectura y escritura
- datos y metadatos en almacenamiento gestionado por Snowflake o en tu propia nube (external volume)
- es la opción recomendada cuando Snowflake es el motor principal de escritura
- también puede interoperar: una tabla Snowflake-managed puede exponerse a motores externos compatibles con Iceberg REST mediante Snowflake Horizon Catalog (los clientes de Snowflake Open Catalog aún pueden usar su sincronización, pero Horizon Catalog es la opción recomendada actualmente)
- Catálogo externo (tabla gestionada externamente)
- Snowflake puede consultar tablas Iceberg compatibles gobernadas por catálogos externos soportados
- también puede escribir sobre tablas de un catálogo remoto compatible con Iceberg REST, ya sea mediante una base de datos vinculada al catálogo (catalog-linked) con las operaciones de escritura habilitadas, o registrando la tabla —que ya exista en el catálogo remoto— en una base de datos estándar de Snowflake; soportado para spec Iceberg v2 y v3, con algunas limitaciones
- admite actualización automática de los metadatos de la tabla (AUTO_REFRESH)
External Volume: tu almacenamiento, bajo tu control
Para guardar datos y metadatos Iceberg en tu propia nube, creas un external volume y lo referencias desde la tabla. El volumen apunta a tu bucket (por ejemplo, S3) con el rol de acceso correspondiente.
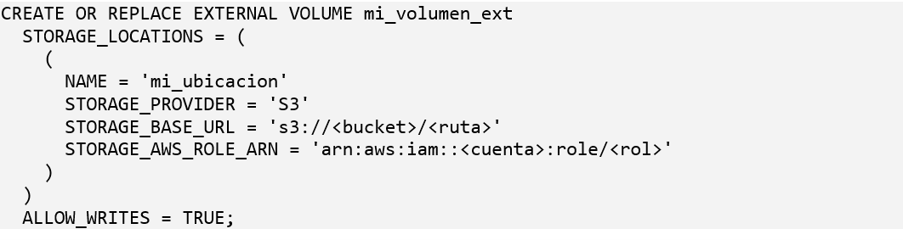
Importante: crear el objeto no cierra la integración. Para que funcione (y sea escribible) necesitas configurar la política y la trust policy del rol IAM, recuperar el principal con DESC EXTERNAL VOLUME, verificar la conexión con SYSTEM$VERIFY_EXTERNAL_VOLUME, y permitir escritura con ALLOW_WRITES = TRUE (más los permisos de almacenamiento, p. ej. s3:PutObject).
Si prefieres usar el almacenamiento del propio Snowflake en lugar de tu propia nube, indica EXTERNAL_VOLUME = ‘SNOWFLAKE_MANAGED’: en ese caso los ficheros residen en almacenamiento provisto por Snowflake, no en tu cuenta cloud.
Crear una Iceberg Table gestionada por Snowflake
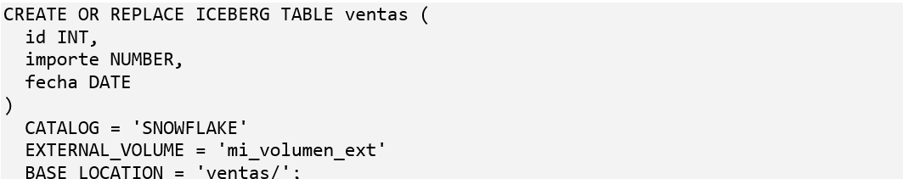
Con Snowflake como catálogo, defines la ubicación de almacenamiento (un external volume o SNOWFLAKE_MANAGED) y una base location donde Snowflake escribe datos y metadatos:
Tablas gestionadas por un catálogo externo
Cuando la tabla la gobierna un catálogo externo, la referencias por su nombre en dicho catálogo y, opcionalmente, activas la actualización automática de metadatos. Este ejemplo corresponde a un catálogo Iceberg REST / AWS Glue:
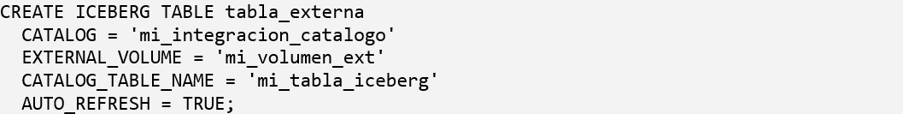
No es una sintaxis universal: según el catálogo puede requerirse CATALOG_NAMESPACE, y para tablas creadas directamente desde ficheros de metadatos se usa otra variante con METADATA_FILE_PATH (orientada a lectura). AUTO_REFRESH exige una integración compatible y bien configurada.
Convertir una tabla externa a gestionada por Snowflake
Si una tabla empieza gestionada por un catálogo externo y luego quieres que Snowflake la gobierne (para obtener soporte completo de la plataforma y gestión de su ciclo de vida), puedes convertirla:

La política de serialización admite COMPATIBLE (máxima interoperabilidad con otros motores) u OPTIMIZED (codificación y compresión orientadas al rendimiento dentro de Snowflake).
Antes de convertir: refresca la tabla (ALTER ICEBERG TABLE … REFRESH), asegúrate de que el external volume permite escritura (ALLOW_WRITES = TRUE) y de tener los permisos de almacenamiento y el OWNERSHIP necesarios. Ten en cuenta estos límites: la conversión no está soportada para tablas que pertenezcan a una catalog-linked database, ni admite columnas de tipo uuid o fixed(L). Además, el tratamiento del particionado depende de la versión de Iceberg: en tablas v2 se elimina el particionado existente durante la conversión, mientras que en tablas v3 se conserva. A partir de la conversión, Snowflake asume el ciclo de vida de la tabla y deben evitarse escritores externos concurrentes.
Cuándo usar Iceberg Tables (y cuándo no)
Encajan bien cuando:
- ya tienes un data lake en formato abierto que no quieres duplicar
- necesitas interoperabilidad: varios motores leyendo el mismo dato
- quieres evitar el bloqueo de formato y mantener los datos en tu propia nube
Probablemente no compensan cuando:
- todo el ciclo de vida del dato permanece dentro de Snowflake, sin consumo externo
- buscas la máxima simplicidad operativa: las tablas estándar requieren menos piezas
- no necesitas formato abierto ni almacenamiento gestionado por ti
Por dónde empezar (quick wins)
- identifica qué datasets se duplican hoy entre data lake y warehouse
- decide primero el modelo de catálogo (Snowflake o externo)
- para tu propia nube, crea el external volume y habilita ALLOW_WRITES si vas a escribir
- empieza con una tabla gestionada por Snowflake (lectura y escritura completas)
- usa AUTO_REFRESH solo en tablas gobernadas por catálogos externos
- define la base location y la convención de nombres antes de escalar
- planifica el mantenimiento (compactación, expiración de snapshots) y vigila los costes
Conclusión
Las Iceberg Tables acercan el data lake y el data warehouse evitando una segunda copia analítica dentro de Snowflake.
Las claves de la decisión:
- catálogo: Snowflake-managed cuando Snowflake debe controlar el ciclo de vida y dar el soporte más completo; catálogo externo cuando otro catálogo debe seguir siendo la fuente de verdad de la tabla
- almacenamiento: provisto por Snowflake o tu propia nube mediante external volume
- formato abierto Parquet + Iceberg: el mismo dato, varios motores
Primero define el modelo de catálogo y el almacenamiento. Luego construye sobre formato abierto.
¿Tu plataforma de datos está aprovechando el formato abierto y la interoperabilidad de Iceberg?
En Bravent ayudamos a organizaciones a diseñar, optimizar y escalar sus plataformas de datos, eligiendo la arquitectura adecuada (lakehouse, warehouse o híbrida) para evitar duplicidades, costes innecesarios y dependencias de formato.
📩 Escríbenos a: info@bravent.net